
一零基础阶段掌握核心原理与基础技术此阶段需系统学习爬虫所需的理论知识,并通过实战案例掌握主流网站的数据抓取方法,目标是具备独立抓取静态动态网页数据的能力基础知识储备 计算机网络理解。
学习网络爬虫的三个阶段 对于零基础的小白来说,学习网络爬虫大体上可以分为三个阶段入门阶段 在这一。
入门Python爬虫需要明确学习目标掌握基础知识选择合适的工具,并注意合法性以下是详细步骤和建议明确需求首先确定是否真的需要爬虫如果公司已有数据库支持业务分析,可能无需学习爬虫爬虫主要用于从互联网上搜集特定数据,提高工作效率或实现自动化表格构建了解爬虫流程爬虫通常包括四个步骤模拟浏览器发起请求获取响应内。
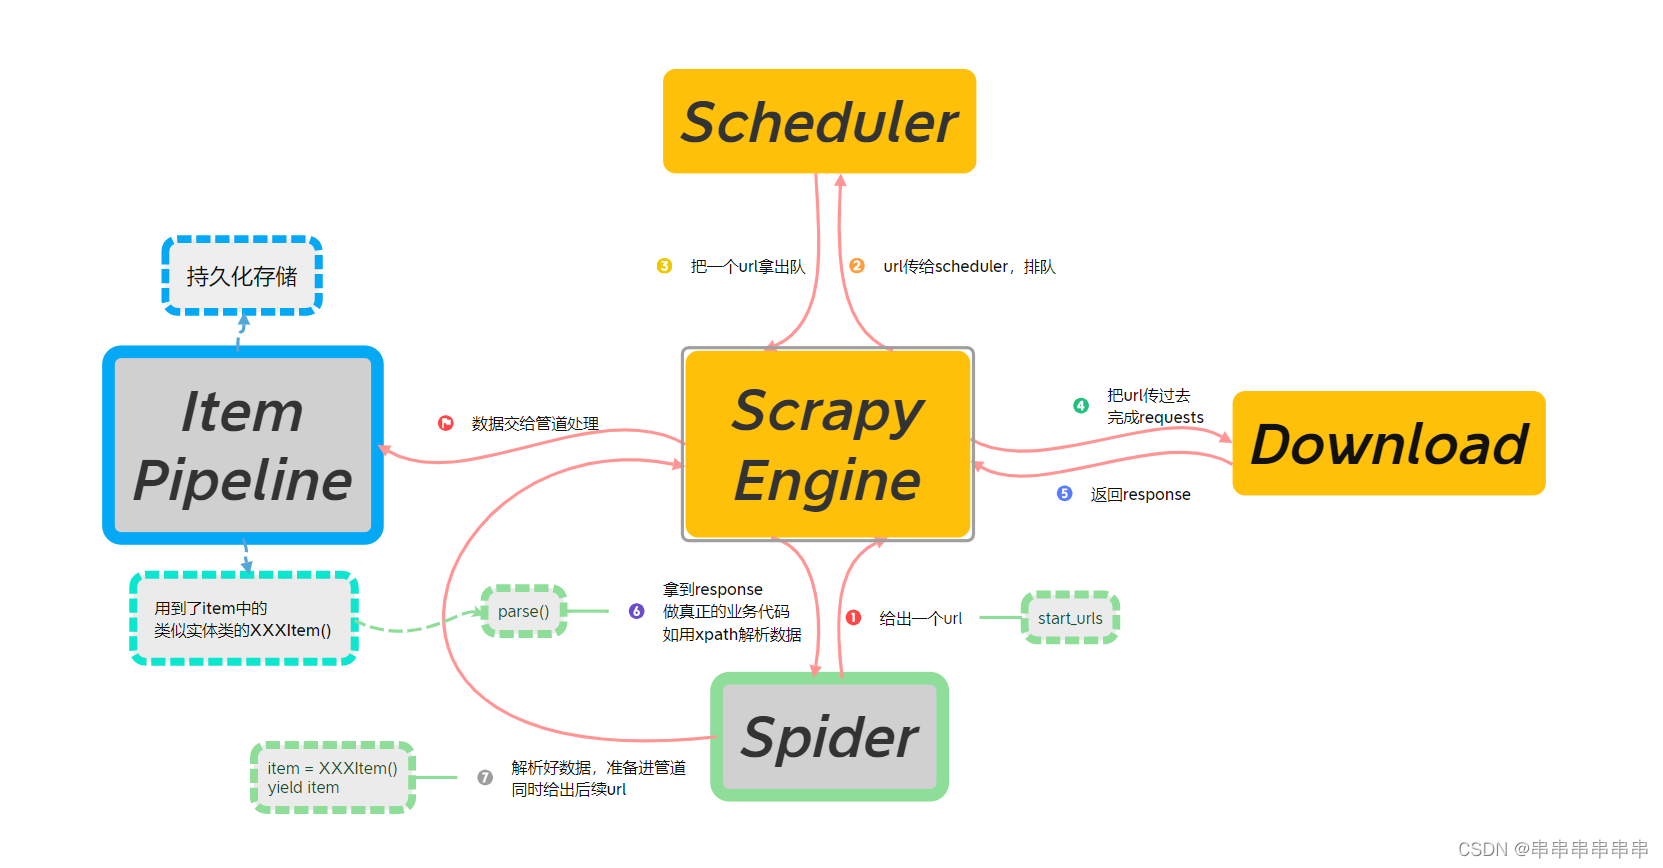
02 爬虫入门 Python基础掌握差不多后,就是爬虫入门,初学的话,可以使用urllibrequestsbs4lxml等基础爬虫库,简单易学,容易掌握,而且官方自带有非常详细的入门教程,非常适合初学者,对于爬取一些常见的web页面或网站来说,可以说是手到擒来,非常简单,先请求数据,然后再解析就行03 爬虫框架。
Python爬取网页数据及爬虫入门实战步骤Python爬取网页数据核心步骤为发出请求解析内容提取数据,入门实战主要围绕requests库和BeautifulSoup库展开,具体可分为以下几个阶段一明确目标与初步侦察确定爬取目标在开始编写代码前,需明确要抓取的数据内容,例如商品价格新闻标题评论信息等使用浏览器。
八爪鱼爬虫软件新手入门分页列表信息采集教程 步骤1新建任务并输入网址 登陆八爪鱼采集器点击“新建。
Python爬虫学习系列教程概览 Python爬虫技术是一项非常实用且有趣的技能,它能够帮助我们自动化地获取网络上的数据以下是一个系统的Python爬虫学习系列教程概览,旨在帮助你从入门到进阶,全面掌握Python爬虫技术一爬虫入门 Python爬虫入门一之综述 了解爬虫的基本概念工作原理以及应用场景掌握Python编程。
Python网络爬虫从入门到实践第2版是一本面向初学者的爬虫实战教程,系统讲解正则表达式Beautiful SoupScrapy框架及反爬策略,并涵盖数据存储与并发下载本PDF为高清完整版,内容详实,案例代码清晰,适合想系统学习网络爬虫提升数据采集能力的读者阅读点击链接获取网盘资源。
通过前期的学习,我们已经掌握了如何采集单页数据,包括列表表格以及点击链接后进入详情页的数据在实际应用中,我们经常会遇到需要翻页以获取更多数据的情况对于这类需要翻页的网站,我们如何操作呢本篇教程将详细讲解常见的网页翻页类型以及使用八爪鱼软件实现翻页的方法首先,最常见的一种翻页方式是。
八爪鱼爬虫软件教程6新手入门智能模式智能模式是八爪鱼采集软件中一种方便快捷的采集模式,特别。
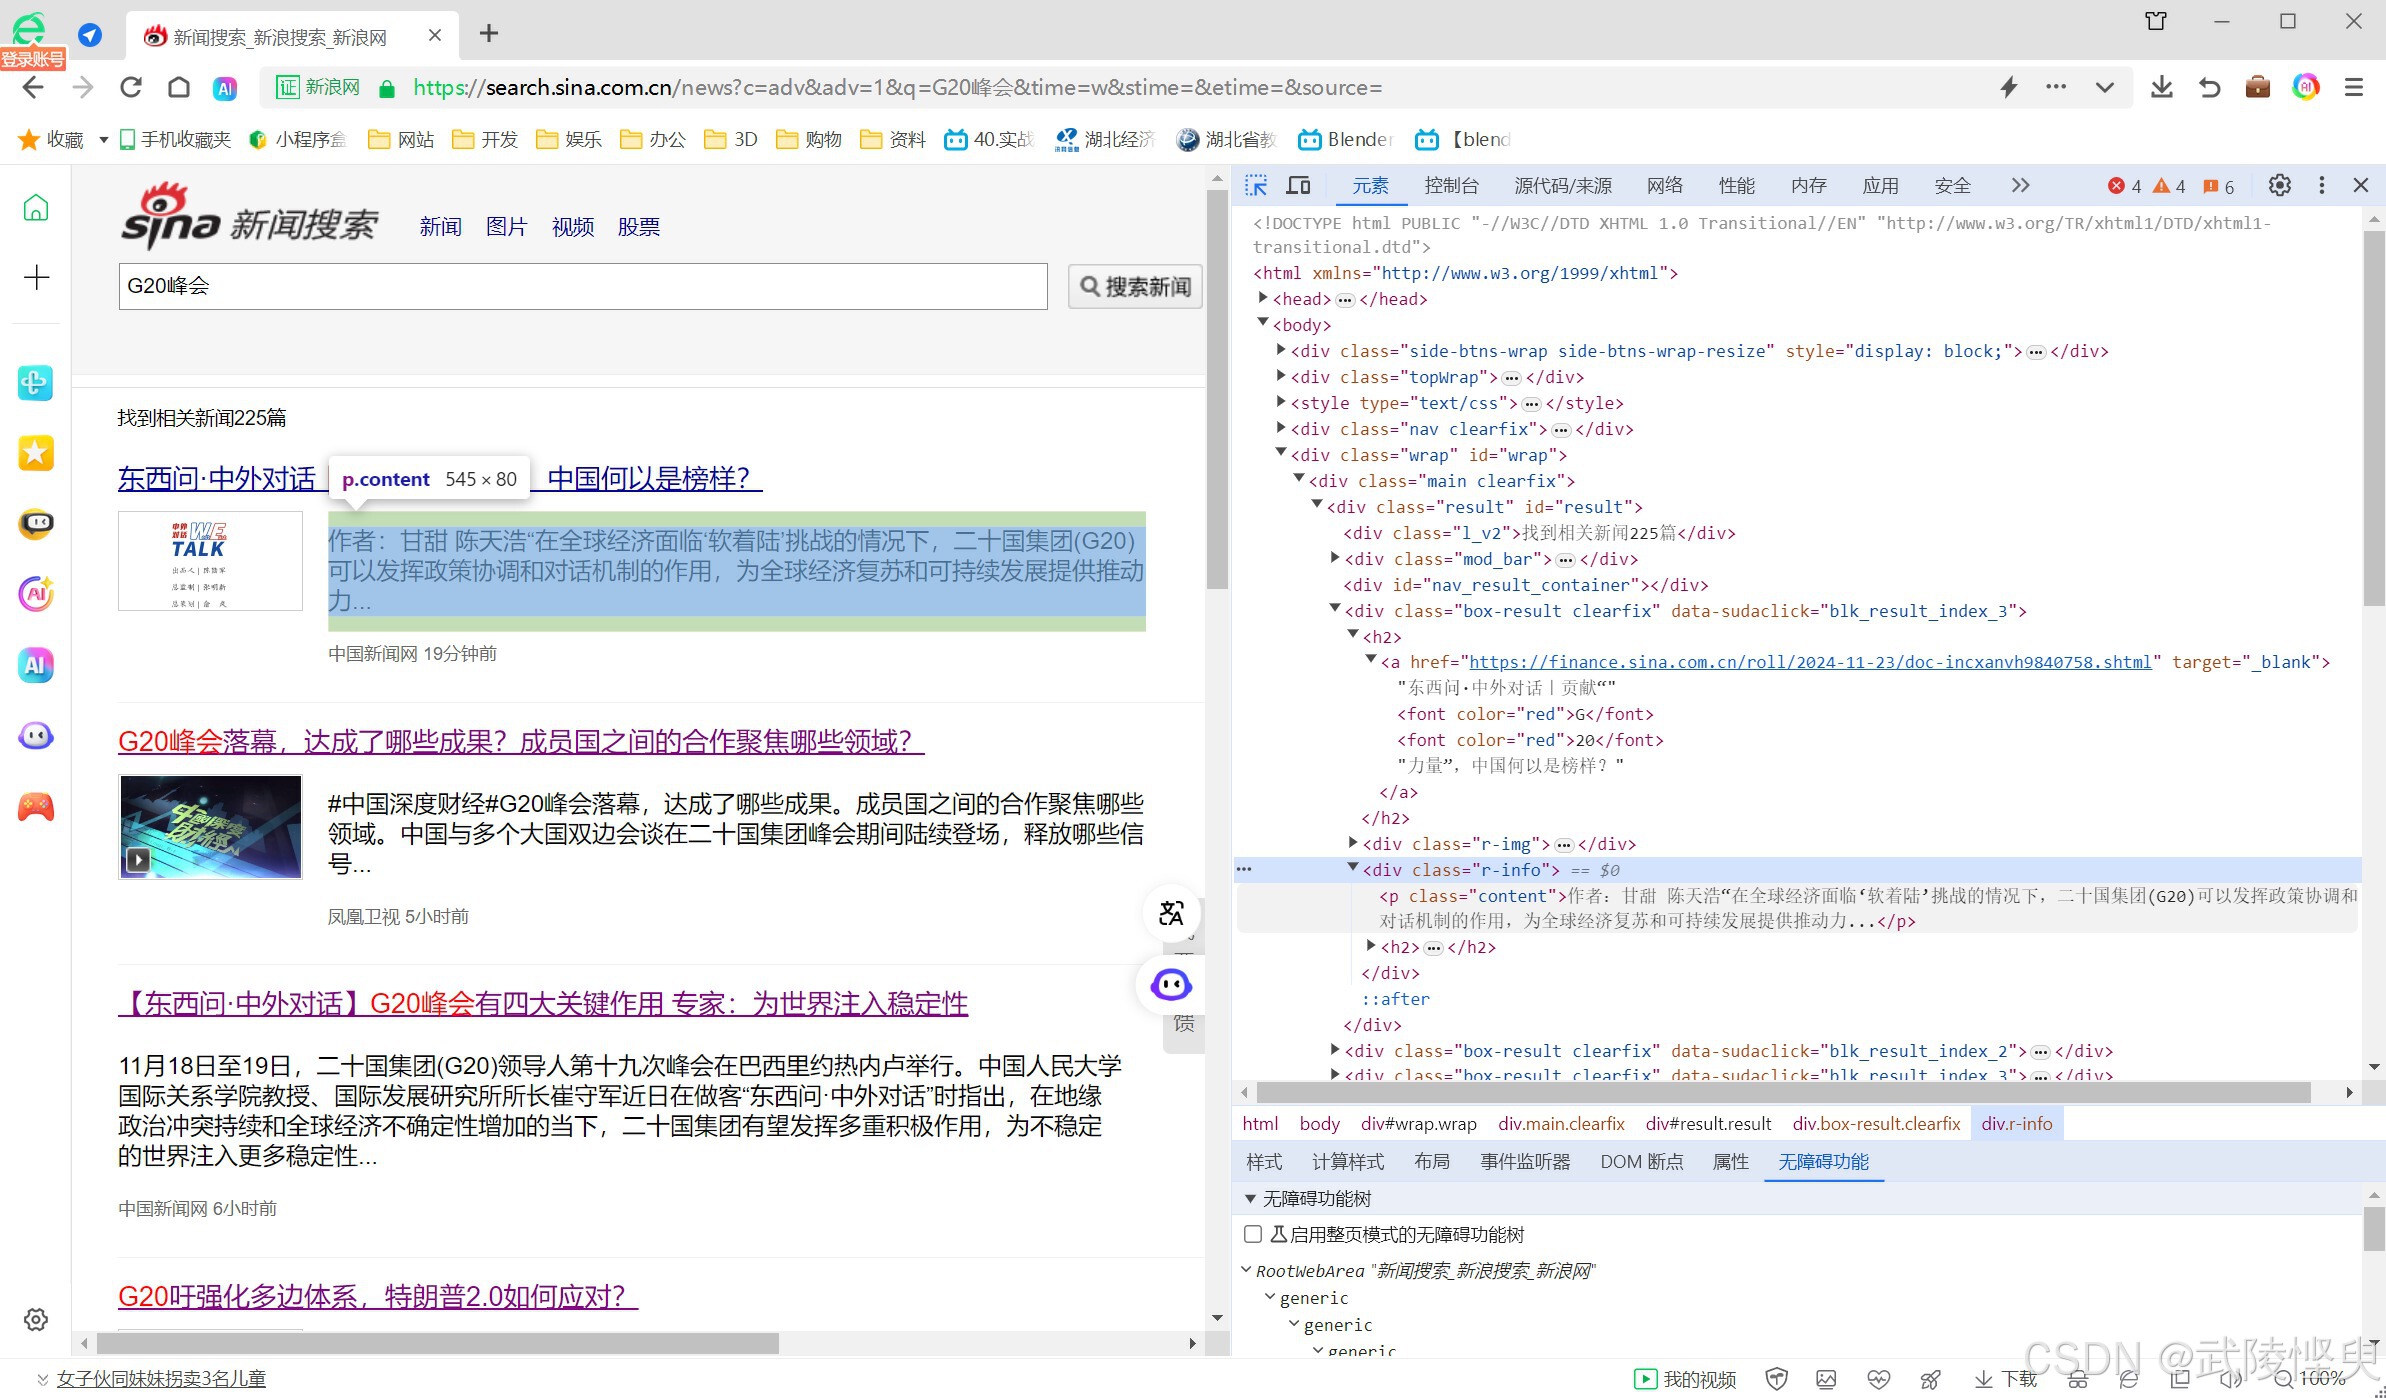
通过 了解爬虫的定义与流程后,我们转向如何对网站数据进行分析,首先需要学会数据抓包对于网页爬取,我们需知道如何请求及获取数据类型在Chrome浏览器中,我们可以通过按下F12打开开发者工具,借助此工具,可以分析Element标签下的HTML代码,进而了解网页结构在Chrome浏览器中输入网址并回车,加载页面后按。
爬虫的入门课程,让大家充分了解理解爬虫的原理,再学会使用 python 进行网络请求的同时,还能掌握如何爬取。
了解html和简单的js,只有了解你要抓取的页面,在获取后才能有效分析建议系统学习html这个很简单js较复杂不必多看,可以边分析边百度资料学习python方面,了解urllib和urllib2两个库,在抓取页面要用到Cookielib这个库配合urllib2可以封装opener,在需要cookie时可以自动解决,建议了解一些,会封装opener。
作为零基础的你,我想你可能是想解决工作中的一个实际问题,或者仅仅是很想学习一下爬虫的技术,多一技之长其实我准备开始学 Python 爬虫的时候也是一样,老板派了任务,暂时没有人会爬虫,我只有自学顶硬上因此,我可以用思维图给你理清楚,你应该干什么我零基础但我想学网络爬虫路径1我不。
本文来自作者[镇建柏]投稿,不代表调研号立场,如若转载,请注明出处:https://kydy.org.cn/miao/9053.html



评论列表(4条)
我是调研号的签约作者“镇建柏”!
希望本篇文章《关于网络爬虫新手入门教程的信息》能对你有所帮助!
本站[调研号]内容主要涵盖:调研号,生活百科,小常识,生活小窍门,百科大全,经验网
本文概览:一零基础阶段掌握核心原理与基础技术此阶段需系统学习爬虫所需的理论知识,并通过实战案例掌握主流网站的数据抓取方法,目标是具备独立抓取静态动...